
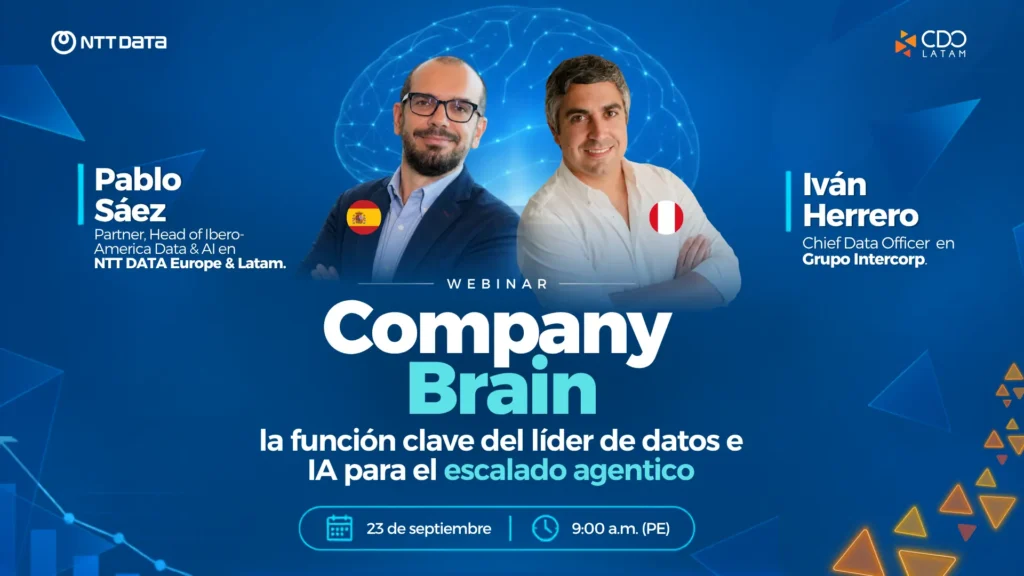
El miércoles 23 de septiembre de 2026, CDO LATAM realizó el webinar «Company Brain: La función clave del líder de datos e IA para el escalado agéntico», con el patrocinio de NTT DATA. El encuentro contó con la participación de Pablo Sáez, Partner, Head of Ibero-America Data & AI en NTT DATA Europe & Latam, e Iván Herrero, Chief Data Officer en Grupo Intercorp.
Durante la sesión, ambos profesionales abordaron cómo las organizaciones pueden estructurar y gobernar su conocimiento para que los agentes de inteligencia artificial compartan definiciones de negocio, accedan a información confiable y ejecuten procesos bajo reglas y políticas comunes. La conversación también profundizó en el concepto de Company Brain, una propuesta para facilitar la reutilización del conocimiento corporativo y el escalado de la IA agéntica.
El interés de la audiencia dio lugar a numerosas preguntas sobre gobierno del conocimiento, arquitectura tecnológica, implementación y el papel de las personas. Debido al tiempo disponible, algunas quedaron pendientes y otras no pudieron desarrollarse con mayor detalle.
Para dar continuidad a esta conversación, Pablo Sáez preparó las respuestas a 28 preguntas de los participantes, que compartimos a continuación, organizadas en cuatro bloques temáticos.
1. Gobierno de datos y conocimiento
¿El gobierno de datos se transforma en gobierno del conocimiento, o conviven?
Conviven. El gobierno de datos no desaparece. El dato sigue siendo el sistema de registro, y la calidad, el linaje y los permisos sobre tablas y columnas continúan siendo necesarios.
Lo que aparece es una nueva capa con objetos propios que el gobierno tradicional no gestionaba, como definiciones canónicas, reglas y políticas ejecutables, procesos, skills, memoria y trazas de decisión.
Estos elementos tienen su propio ciclo de vida, versiones y responsables. Por ello, hablamos del gobierno del conocimiento como una ampliación del gobierno de datos, no como su reemplazo.
¿Siguen siendo necesarios el data owner y el data steward?
Aunque todavía no existe una definición universalmente aceptada para estos nuevos roles, como ocurre con algunos conceptos recogidos en marcos como DAMA, todo indica que seguirán existiendo los Data Owners y Data Stewards.
A ellos se sumaría el Knowledge Steward, responsable de certificar el significado del conocimiento, resolver conflictos entre definiciones, aprobar lo que propone la IA y determinar qué información se considera canónica.
En muchas organizaciones, este rol podría asumirlo un Data Steward con responsabilidades ampliadas. Sin embargo, necesitaría tiempo asignado y autoridad para resolver discrepancias. Un responsable sin estas condiciones difícilmente podrá sostener un Company Brain.
¿Quién cura la base de conocimiento para que siga sana en el tiempo?
La responsabilidad debe compartirse entre el responsable del dominio, el Knowledge Steward y los expertos del negocio (SMEs), que aportan el conocimiento tácito que no se encuentra documentado.
La curación debe formar parte de la operación continua. Una base de conocimiento necesita mantenimiento, revisión y actualización para conservar su utilidad.
Sin recursos recurrentes destinados a esa tarea, el Company Brain corre el riesgo de convertirse en un proyecto que pierde vigencia con el tiempo.
¿Es posible un Company Brain sin gobierno de datos? ¿Es requisito?
Técnicamente es posible construirlo, pero su sostenibilidad operativa depende de contar con responsables, definiciones acordadas y trazabilidad.
Esto no significa que la organización necesite un gobierno de datos completamente maduro antes de comenzar.
Es suficiente establecer un gobierno adecuado para el dominio del primer caso de uso. Precisamente por eso tiene sentido empezar con un Domain Brain, en lugar de intentar construir toda la iniciativa corporativa al mismo tiempo.
¿Todo esto sigue siendo responsabilidad del área de Gobierno de Datos?
La distribución de responsabilidades puede variar entre organizaciones.
Nuestra propuesta es que el área de Datos asuma la definición del modelo de gobierno del conocimiento, incluidos sus estándares, roles, mecanismos de certificación y políticas.
Sin embargo, el conocimiento de cada dominio pertenece al área de negocio correspondiente.
Si el área de Gobierno de Datos intenta asumir la responsabilidad de validar el significado de toda la organización, puede convertirse en un cuello de botella que dificulte la actualización del Company Brain.
¿Cómo se mantiene el gobierno postproducción, cuando cambia el contexto o entran datos sensibles nuevos?
El control de versiones y las políticas de certificación son fundamentales para mantener actualizado el Company Brain.
En el modelo propuesto, cuando aparecen nuevos datos, cambia un esquema o se modifica una política, los activos afectados deben perder parte de su nivel de confianza y volver al proceso de revisión del Knowledge Steward.
La certificación no es permanente. Depende de una fecha, una versión y un contexto determinado.
También resulta fundamental conservar una memoria de decisiones. Cada respuesta debería registrar qué definiciones utilizó, qué activos consultó, qué políticas verificó y quién certificó ese conocimiento.
Esta trazabilidad permite revisar posteriormente por qué un agente tomó determinada decisión.
¿Los accesos se podrían manejar por entidades de datos más que por usuarios?
Es una dirección hacia la que creemos que evolucionará el modelo.
El principio consiste en que el agente actúe mediante la identidad delegada del usuario o mediante una identidad de servicio con permisos mínimos y mecanismos de auditoría.
Las políticas podrían expresarse sobre entidades y conceptos de negocio, mediante reglas de enmascaramiento de atributos, filtros por segmentos o restricciones según roles.
De esta manera, el control de acceso no dependería únicamente de configuraciones individuales de usuarios.
¿El diccionario de datos que elaboramos para Gobierno del Dato sirve para la capa de conocimiento?
Sí. De hecho, puede ser uno de los activos más útiles para comenzar.
El diccionario ya contiene términos, definiciones, responsables y acuerdos alcanzados dentro de la organización.
Estos elementos pueden alimentar inicialmente el Company Brain con un nivel de confianza elevado, lo que facilita su posterior revisión y certificación por parte del Knowledge Steward.
¿Cómo asegurar el nivel de calidad óptimo para que cualquier agente o humano reutilice ese conocimiento?
Nuestra propuesta es establecer un contrato de reutilización, similar al que se utiliza con los productos de datos.
Cada activo publicado debería declarar su responsable, definición, actualidad, cobertura y nivel de certificación.
A partir de esa información, se establecen condiciones de consumo según el riesgo de cada caso de uso.
Por ejemplo, un dashboard exploratorio podría utilizar conocimiento con un nivel de confianza medio, mientras que un proceso regulado necesitaría una certificación completa.
El nivel de confianza debe formar parte del contrato de consumo.
2. Tecnología, arquitectura y plataformas
¿RDF y OWL siguen siendo válidos para definir la ontología? ¿Han evolucionado alternativas?
RDF, OWL y SHACL continúan siendo opciones válidas, especialmente cuando se necesita interoperabilidad entre organizaciones, razonamiento formal o el uso de estándares de dominio.
En sectores como banca y salud existen modelos y estándares, como FIBO y HL7 FHIR, que pueden servir como punto de partida.
Por otro lado, los grafos de propiedades, como Neo4j, han ganado terreno en implementaciones corporativas por su menor curva de aprendizaje, herramientas disponibles y rendimiento para recorrer relaciones.
También existe una convergencia entre ambos enfoques, con plataformas que permiten importar, exportar o trabajar con diferentes modelos de grafos.
Si una organización ya tiene una ontología madura, no debería descartarla únicamente por adoptar una tecnología más reciente.
¿La capa de «conocimiento bruto» es la capa semántica?
En nuestro modelo son conceptos diferentes, aunque todavía no existe una terminología universalmente aceptada para esta disciplina.
El conocimiento bruto es aquel que se ha extraído o identificado, pero aún no se ha certificado. Incluye entidades, relaciones, metadatos, reglas no validadas y contenido no estructurado.
La capa semántica representa entidades, atributos, dimensiones y métricas, además de su ubicación técnica en los sistemas de datos.
Su función dentro de esta arquitectura es permitir que la inteligencia artificial traduzca el lenguaje de negocio utilizado por los agentes al lenguaje técnico necesario para consultar los datos.
¿Cuál es la diferencia entre el Company Brain y la capa semántica que ya se está implantando en varias compañías?
En nuestra concepción, la capa semántica es uno de los componentes del Company Brain.
El Company Brain contempla entidades, relaciones, taxonomías, procesos, skills, políticas y memoria de decisiones. También incluye mecanismos para exponer ese conocimiento a los agentes y mantener un ciclo de aprendizaje.
Cuando necesita obtener información de los sistemas corporativos, utiliza la capa semántica para traducir los conceptos de negocio en consultas sobre los datos correspondientes.
Por tanto, el Company Brain abarca capacidades adicionales a las de una capa semántica tradicional.
¿Cuál es la diferencia entre un agente con RAG sobre fuentes documentales y un agente con Company Brain?
La diferencia principal, según el modelo propuesto, está en el gobierno y el determinismo del conocimiento.
Un sistema RAG recupera información a partir de su similitud con la consulta. Sin mecanismos adicionales, puede tener dificultades para reconocer que dos documentos contienen definiciones distintas del mismo concepto, identificar cuál está vigente o resolver contradicciones.
El Company Brain busca ofrecer conocimiento certificado, con definiciones consistentes, políticas ejecutables y trazabilidad de las decisiones.
Esto no significa que RAG deba desaparecer. Puede formar parte del Company Brain como mecanismo de recuperación de información documental.
La diferencia está en utilizarlo dentro de una arquitectura que incorpore gobierno, certificación y control del conocimiento.
Trabajo en GCP. ¿Cómo ves el Knowledge Catalog y cómo lo usaría como fuente de conocimiento para mis agentes?
Google amplió la propuesta de su catálogo de datos con Knowledge Catalog, anteriormente conocido como Dataplex Universal Catalog, y lo orientó hacia la construcción de contexto para agentes.
Esta evolución puede interpretarse como una aproximación a algunas de las capacidades que propone el Company Brain.
Para organizaciones cuya plataforma de datos e IA ya se encuentra en Google Cloud, Knowledge Catalog puede constituir uno de sus componentes.
Sin embargo, el modelo completo requiere capacidades adicionales que podrían necesitar desarrollo o integración con otras herramientas.
¿Tecnologías como Work IQ de Copilot aspiran a este concepto? El problema es que ese dato no está curado como el estructurado.
Work IQ es una propuesta de Microsoft para proporcionar contexto organizacional a Copilot y sus agentes mediante capacidades relacionadas con datos, memoria e inferencia.
Forma parte de una familia de soluciones que también incluye Fabric IQ y Foundry IQ.
Microsoft, Google y otros proveedores tecnológicos están desarrollando aproximaciones relacionadas con el conocimiento y el contexto corporativo.
Sin embargo, disponer de estas herramientas no elimina la necesidad de curar, validar y gobernar la información, tal como propone el modelo de Company Brain.
¿Dónde vive el knowledge framework? ¿Qué plataformas son las sugeridas?
Actualmente no reside necesariamente en una única plataforma.
El framework se construye mediante una combinación de repositorios, flujos, soluciones tecnológicas, roles y metodologías, según el tipo de conocimiento que se necesita gestionar.
Puede incorporar grafos, archivos JSON o YAML, Markdown, bases vectoriales y registros de actividad.
Sobre estos componentes se integra una capa de agentes y asistentes que facilita tanto el ciclo de vida del conocimiento como su exposición a otros agentes.
¿Cómo y con qué herramientas se incorporaría este Company Brain?
Actualmente no existe una solución única que reúna todas las capacidades del modelo.
Los principales proveedores tecnológicos y de nube están ampliando sus soluciones para cubrir diferentes partes del ciclo de vida del conocimiento.
En NTT DATA hemos desarrollado un acelerador que permite iniciar proyectos sin construir todos los componentes desde cero.
Este enfoque busca aprovechar distintas plataformas y soluciones tecnológicas según las necesidades y arquitectura de cada organización.
¿Los sistemas críticos, ERP, WMS, CRM y Finance, marcan la diferencia como fuentes?
Sí. Estos sistemas continúan siendo, en muchos casos, los sistemas de registro (Systems of Record) donde residen los datos operativos de referencia de la compañía.
Un aspecto fundamental es cómo exponen la información y las transacciones para que puedan ser utilizadas por agentes de IA.
Esto incluye mecanismos de integración como MCP.
Aunque es un desafío diferente al de construir el Company Brain, resulta importante para lograr el escalado agéntico dentro de la operación empresarial.
3. Por dónde empezar
¿Cuáles deberían ser los primeros pasos para un CxO?
En nuestra visión, el CDO o CDAO debería liderar la creación de la plataforma y de la capacidad corporativa de gestión del conocimiento, al menos durante el desarrollo inicial de un MVP.
Posteriormente, cada área de negocio debe asumir la responsabilidad sobre sus propios datos, conocimientos y procesos.
Una secuencia recomendada sería:
- Elegir un proceso o flujo de negocio crítico, en lugar de comenzar con un piloto exclusivamente experimental.
- Inventariar los activos existentes, como glosarios, catálogos, modelos semánticos, taxonomías y documentación de procesos.
- Designar un Knowledge Steward con autoridad y responsabilidades definidas.
- Desarrollar una ontología mínima viable del dominio y la capa semántica necesaria para el caso.
- Definir indicadores para evaluar la actualización, cobertura y certificación del conocimiento.
El objetivo es comenzar con un alcance limitado, pero preparado para su posterior reutilización.
¿Cómo describir un journey para organizaciones que no están en un nivel avanzado de madurez digital?
No es necesario alcanzar una madurez digital avanzada en toda la organización antes de comenzar.
La recomendación es avanzar por dominios, en lugar de intentar transformar simultáneamente todas las áreas.
Conviene seleccionar un dominio que ya disponga de procesos relativamente organizados y documentados.
Un ejemplo puede ser el área de Tecnología, particularmente el ciclo de vida del desarrollo de software (SDLC), que suele contar con procedimientos, repositorios y documentación técnica.
Este primer dominio puede servir para desarrollar experiencia antes de extender el modelo a otras áreas.
¿Cómo hacer este proceso de forma ágil y qué recursos demanda?
La agilidad consiste en evitar el modelado exhaustivo de todo el conocimiento desde el inicio.
Aunque se puede partir de un modelo de referencia amplio, el trabajo de detalle debería concentrarse en las preguntas que el negocio necesita responder.
Por ejemplo, se pueden seleccionar diez o quince preguntas relevantes y modelar únicamente las entidades, relaciones y reglas necesarias para responderlas.
El alcance debe estar determinado por el caso de uso y no por la intención de completar toda la arquitectura antes de obtener resultados.
¿Conviene empezar con PoCs y casos concretos antes de grandes contrataciones?
Sí.
En NTT DATA hemos desarrollado el acelerador Semantic Knowledge Hub para facilitar la construcción de pruebas de concepto con resultados concretos.
La intención es que los componentes desarrollados durante estas primeras pruebas puedan reutilizarse posteriormente en MVP y proyectos de mayor escala.
De esta manera, una prueba de concepto puede contribuir a la construcción progresiva del Company Brain, en lugar de convertirse en una demostración aislada.
¿Cuál debería ser el racional, los unit economics y el criterio de build vs. buy?
Actualmente consideramos que ninguna solución disponible cubre por completo todas las capacidades del Company Brain.
Por eso, probablemente sea necesario combinar componentes adquiridos, como repositorios y motores de grafos, con desarrollos propios.
La ontología, las definiciones de negocio y las skills específicas de cada compañía requieren trabajo interno, ya que representan su conocimiento particular.
En cuanto a los unit economics, no evaluaría únicamente el costo del primer caso de uso.
También mediría el costo, el plazo de implementación y los beneficios de los casos posteriores.
Una gestión centralizada y reutilizable del conocimiento debería permitir reducir el esfuerzo de recrear definiciones y reglas en cada nuevo desarrollo agéntico.
¿Cómo balancear la gestión del dato con la necesidad de velocidad del negocio?
El equilibrio debería establecerse según el riesgo de cada caso de uso, no mediante una regla uniforme para toda la empresa.
En el modelo propuesto, un motor de confianza determina cómo puede utilizarse cada activo de conocimiento.
- Confianza alta: el activo puede utilizarse automáticamente.
- Confianza media: se entrega como provisional y el consumidor evalúa si resulta adecuado.
- Confianza baja: el activo no se utiliza para tomar decisiones.
Esto permite automatizar el consumo de conocimiento cuando existe suficiente confianza y aplicar controles adicionales en las situaciones de mayor riesgo.
4. Agentes, determinismo y factor humano
Si el componente es determinístico, ¿no sería mejor usar una tecnología distinta a la IA?
En el modelo de Company Brain, la inteligencia artificial puede utilizarse para facilitar el ciclo de vida del conocimiento, particularmente en la comprensión del lenguaje, la desambiguación, la orquestación y la gestión de excepciones.
Sin embargo, el cálculo, la aplicación de políticas, las skills compartidas y la ejecución de procesos pueden mantenerse bajo mecanismos deterministas.
La IA no necesita intervenir en todas las etapas de una operación para que forme parte de una arquitectura agéntica.
¿Un proceso determinístico debe migrarse a IA agéntica? ¿Qué casos aplican?
No es necesario migrar un proceso determinístico a IA agéntica únicamente por adoptar esta tecnología.
Sin embargo, a medida que las organizaciones incorporen arquitecturas basadas en agentes, determinados procesos podrían integrarse como herramientas que estos utilicen.
Esto permitiría mantener su lógica determinista dentro de una arquitectura más amplia, sin incorporar capacidades generativas donde no sean necesarias.
¿Cómo se integra el pensamiento crítico con la orquestación IA-humano?
El Company Brain busca facilitar el pensamiento crítico mediante respuestas que incluyan su definición, versión, fuente y trazabilidad.
Cuando una persona dispone de esta información, puede evaluar y cuestionar la respuesta de un agente con mayores fundamentos.
Los puntos de intervención humana deberían establecerse según los niveles de confianza y riesgo:
- Confianza alta y riesgo bajo: ejecución automática.
- Confianza media: el agente propone y una persona aprueba.
- Confianza baja o riesgo alto: el sistema no actúa y escala la decisión.
También es importante considerar los errores como parte del aprendizaje.
Para que un fallo contribuya a mejorar el sistema, debe quedar registrado. La memoria de decisiones permite analizarlo y utilizar esa información en posteriores revisiones del conocimiento o ajustes de las skills.
Ahora sí importa tener los procesos documentados, algo que muchas veces se dejaba de lado. ¿Cómo volvemos a lo básico?
Durante años, la documentación de procesos se realizaba principalmente por necesidades de auditoría o cumplimiento, sin que necesariamente tuviera un uso operativo continuo.
Con las arquitecturas agénticas, esa documentación puede transformarse en conocimiento ejecutable que los agentes consultan y utilizan en sus operaciones.
Esto modifica tanto la utilidad como la forma de mantenerla.
Los procesos deberían documentarse en formatos que puedan consumir los agentes, con control de versiones, responsables y fechas de actualización.
La propuesta es avanzar hacia una documentación integrada en repositorios y sistemas de gestión del conocimiento, en lugar de depender exclusivamente de archivos que se almacenan sin mantenimiento.
Menos Word, más repositorio.